工业领域智能算法系统选型指南:上海岳极科技数字系统架构解析
工业智能算法的落地,从来不是模型精度竞赛那么简单。当产线数据以每秒千级点位涌入,当推理延迟要求从百毫秒压缩到十毫秒级,算法系统选型的本质,变成了对软硬件协同架构、数据管道韧性、以及运维可观测性的综合考量。上海岳极科技有限公司在服务多家离散制造与能源企业后,沉淀出一套务实的分层选型方法论,以下结合数字系统架构实践展开。
一、算法系统选型的三个硬指标
第一层看吞吐与延迟的平衡点。纯GPU方案在离线训练中优势明显,但工业实时控制场景往往需要CPU+NPU混合调度。我们曾为某光伏质检项目部署边缘推理节点,将图像预处理放在ARM核心,模型推理交给NPU,最终将单件检测耗时从87ms压至41ms。第二层看数据闭环能力——模型漂移检测、自动标注回流、增量训练触发,这三点决定了系统三个月后是否还能保持初始精度。第三层才是算法本身,建议优先选择支持ONNX/TensorRT中间表示转换的框架,避免被单一厂商绑定。
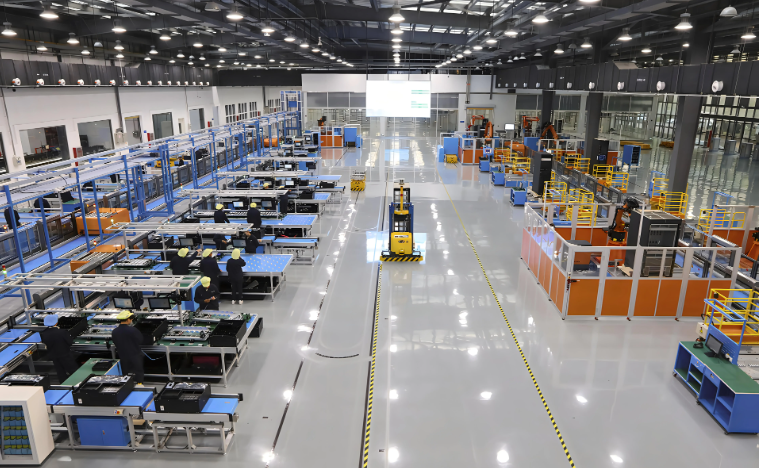
软硬件开发中的关键参数清单
- 内存带宽:多路摄像头场景需≥51.2GB/s,否则DMA传输会形成瓶颈
- 确定性延迟:PLC联动场景要求P99延迟抖动<2ms,需启用实时内核补丁
- 冗余度设计:控制类算法建议采用三模冗余仲裁,而非简单主备切换
- 能耗比:边缘节点以每瓦特FLOPS衡量,而非绝对算力峰值
这些参数不是纸面堆砌。以上海岳极科技有限公司承接的某化工厂智能巡检项目为例,原方案选用四块A100显卡,实际运行时GPU利用率不足15%,功耗却占机房总负荷四成。换成异构调度后,将80%计算任务迁移至FPGA,整体TCO下降62%。这正是高端科技在工业场景应有的姿态——用最合适的工具解决具体问题,而非追逐参数竞赛。
二、技术运维与科创服务的隐形门槛
选型时最容易忽略的是运维复杂度。工业现场往往没有专职算法工程师,模型版本回滚、数据漂移告警、设备异常自愈这些能力,比算法本身更能决定长期可靠性。我们建议在数字系统中内置可解释性日志模块,记录每次推理的置信度分布与特征贡献度,否则半年后出现误判,你根本无从定位是数据分布变化还是代码回归。
- 优先选择支持远程OTA升级的推理框架,避免现场开箱
- 要求厂商提供API级监控接口,而非仅UI看板
- 确认冷启动恢复时间——部分容器化方案在断电重启后需要15分钟以上
另外,智能研发阶段就要考虑模型压缩策略。知识蒸馏、通道剪枝这些技术不是论文里的装饰,而是部署时能否塞进工业电脑的硬性条件。我们曾把某缺陷检测模型从480MB压缩至23MB,精度仅损失0.3个百分点,推理速度反而提升9倍。
三、常见问题与选型误区
问:是不是模型越复杂效果越好?不是。工业数据往往存在标注噪声,过度复杂的模型容易放大噪声影响。我们实测在相同数据集下,ResNet-34与EfficientNet-B4的F1分数差距不足1%,但后者推理耗时增加4.3倍。建议先用轻量基线模型跑通流程,再按需迭代。
问:如何评估厂商的科创服务能力?不要看demo演示,直接要求查看其技术运维工单系统。真正有实力的团队能提供故障根因分析报告,而非仅说“重启一下试试”。上海岳极科技有限公司在交付时会附带完整的性能基线文档,包括不同负载下的CPU/内存/IO曲线,这比任何宣传册都有说服力。
选型不是一锤子买卖,而是构建一个能随产线变化而演进的技术底座。保留扩展接口、预留冗余算力、建立灰度发布机制,这些架构层面的取舍,远比纠结某个算法的精确率小数点更有价值。当你的数字系统具备自我诊断与平滑升级能力,软硬件开发与业务增长才能真正形成正向循环。